
NPU e on-device AI: la svolta dell’inferenza locale in azienda
La tassa nascosta dell’adozione dell’intelligenza artificiale in azienda risiede nei costi di inferenza. Molte organizzazioni che hanno avviato progetti pilota basati su API cloud si trovano oggi di fronte a una realtà insostenibile: ogni singola query genera un costo computazionale ricorrente, mentre la trasmissione di dati sensibili verso server esterni solleva complessi interrogativi di conformità e sicurezza. In questo scenario, l’evoluzione delle NPU (Neural Processing Unit) e dell’on-device AI rappresenta un cambio di paradigma fondamentale, spostando la capacità di calcolo direttamente sui dispositivi degli utenti finali.
Cosa sono le NPU e come stanno ridisegnando l’architettura hardware
Una Neural Processing Unit (NPU), nota anche come acceleratore AI o processore di deep learning, è una classe di hardware specializzato progettato per accelerare le applicazioni di intelligenza artificiale e machine learning. Le NPU possono essere integrate come componenti standalone, oppure far parte di una CPU o di una GPU. Sebbene il termine sia apparso già nel 2012 in un documento di ricerca intitolato “Neural Acceleration for General-Purpose Approximate Programs”, la sua adozione di massa ha subito un’accelerazione straordinaria solo negli ultimi anni.
A differenza delle CPU general-purpose e delle GPU tradizionali, le NPU sono ottimizzate per l’esecuzione efficiente di modelli già addestrati (inferenza). La loro architettura si concentra su calcoli a bassa precisione (come i formati INT4, INT8, FP8 e FP16) e su flussi di dati ottimizzati per la moltiplicazione di matrici. La metrica di riferimento per misurare le prestazioni di una NPU è espressa in TOPS (Trillions of Operations per Second), che solitamente si riferisce a operazioni di addizione e moltiplicazione INT8. Questa focalizzazione ingegneristica consente alle NPU di eseguire compiti complessi consumando una frazione dell’energia richiesta da un processore tradizionale. Per integrare efficacemente queste risorse nell’infrastruttura aziendale, è fondamentale affidarsi a partner esperti nello sviluppo di servizi di architetture API e AI orchestration, capaci di connettere i modelli locali con i sistemi core.
La svolta economica: abbattere i costi di inferenza cloud
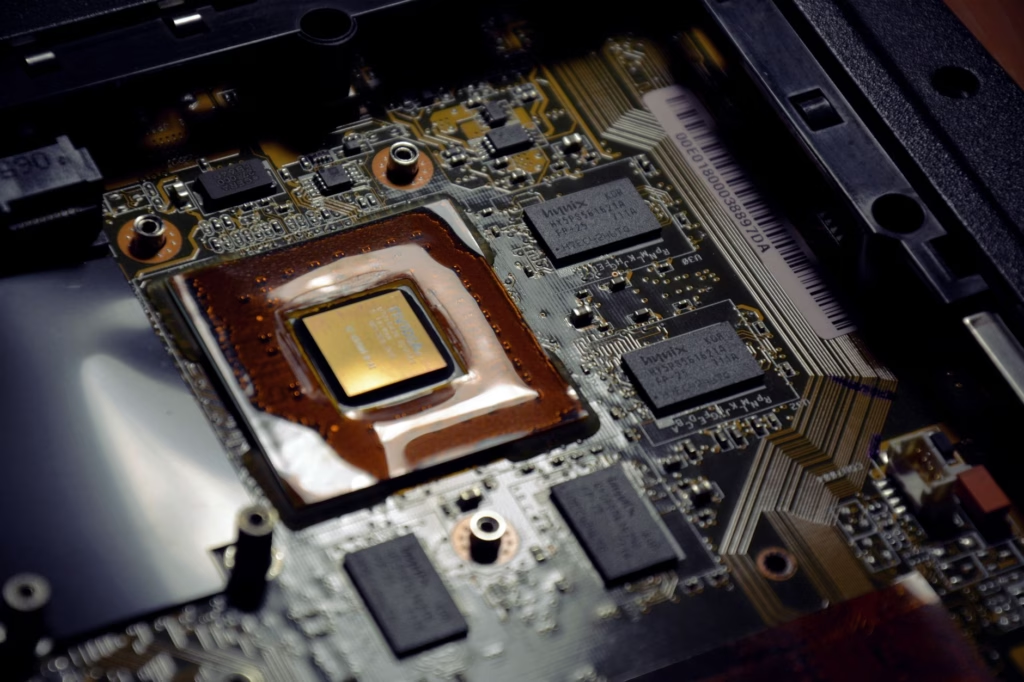
Il costo dell’infrastruttura rappresenta uno dei principali ostacoli alla scalabilità dell’AI generativa. Esternalizzare ogni singola richiesta a modelli ospitati su server remoti comporta spese operative variabili difficili da prevedere. L’introduzione di NPU nei processori consumer (avvenuta nel silicio Apple circa nel 2017 e nei processori Intel e AMD intorno al 2022, inclusi i chip Intel Meteor Lake dotati di VPU versatile) consente di eseguire localmente piccoli modelli linguistici e algoritmi di computer vision.
Spostando l’inferenza sul client, l’azienda elimina il costo marginale per query. Questo approccio ibrido permette di utilizzare il cloud solo per compiti complessi che richiedono modelli di frontiera, mentre le attività quotidiane di produttività, classificazione e analisi dei dati vengono gestite direttamente dall’hardware locale.
L’on-device AI trasforma il calcolo computazionale da un costo operativo variabile e ricorrente a un investimento infrastrutturale ammortizzabile nel tempo.
Sicurezza dei dati e conformità senza compromessi
La privacy delle informazioni aziendali è il secondo grande pilastro che spinge verso l’inferenza locale. Quando i dati vengono elaborati direttamente sulla NPU del dispositivo dell’utente, non vi è alcuna necessità di trasmettere informazioni riservate, codice proprietario o dati dei clienti verso server di terze parti. Questo risolve alla radice i vincoli di compliance legati al GDPR e ai segreti industriali.
La sicurezza non riguarda solo i dati testuali. Le Vision Processing Units (VPU), ad esempio, sono acceleratori specializzati per algoritmi di machine vision come le reti neurali convoluzionali (CNN) e il SIFT. Questi componenti, utilizzati in dispositivi che richiedono il tracciamento visivo degli oggetti come visori per la realtà aumentata e droni, consentono di elaborare flussi video in tempo reale direttamente sul bordo della rete, garantendo la massima riservatezza delle immagini catturate negli ambienti di lavoro.
Dall’edge al data center: un ecosistema hardware in evoluzione
Mentre l’adozione nei dispositivi consumer si concentra sull’efficienza energetica e sulle dimensioni ridotte, l’architettura delle NPU si estende anche ai data center aziendali e al calcolo scientifico. Nei server di cloud computing vengono utilizzati acceleratori proprietari come i TPU di Google Cloud Platform o i chip Trainium e Inferentia di Amazon Web Services. Allo stesso tempo, le GPU moderne progettate da Nvidia (come il chip H100 che contiene decine di miliardi di transistor MOSFET) e AMD includono unità funzionali dedicate alle operazioni di moltiplicazione di matrici a bassa precisione.
Un aspetto tecnico di rilievo per i responsabili IT riguarda la flessibilità di questi acceleratori. Sebbene le NPU siano progettate per calcoli a bassa precisione, possono essere utilizzate per emulare calcoli a precisione più elevata (FP64) nel calcolo scientifico attraverso schemi complessi come l’Ozaki scheme. Questo dimostra come l’hardware per l’AI non sia limitato a semplici compiti di produttività, ma possa supportare simulazioni ingegneristiche complesse con prestazioni superiori rispetto ai sistemi tradizionali.
Linee guida per implementare l’on-device AI in azienda
Per trarre reale vantaggio da questa evoluzione hardware, i decisori tecnologici devono adottare un approccio sistematico che colleghi l’hardware all’architettura software aziendale:
- Valutazione del parco macchine esistente e definizione di un piano di aggiornamento orientato a dispositivi dotati di NPU integrate con prestazioni minime adeguate ai modelli aziendali.
- Ottimizzazione dei modelli linguistici e di computer vision tramite tecniche di quantizzazione (riducendo la precisione a INT8 o INT4) per renderli compatibili con le risorse hardware locali.
- Disegno di architetture software ibride capaci di orchestrare le richieste instradandole dinamicamente tra inferenza locale ed esecuzione in cloud privato.
- Monitoraggio della sicurezza degli endpoint per prevenire tentativi di manipolazione o reverse engineering dei modelli distribuiti sui dispositivi fisici.
La transizione verso un’infrastruttura AI decentralizzata richiede competenze specifiche che uniscono la conoscenza dell’hardware all’ingegneria del software enterprise. Come partner strategico, Exenode supporta le imprese nella progettazione di sistemi intelligenti capaci di sfruttare al massimo l’efficienza delle NPU e dell’on-device AI. Per valutare come ottimizzare i costi di inferenza e proteggere i vostri dati aziendali, potete parlare con il nostro team per avviare un’analisi di fattibilità personalizzata.
Continua a leggere
GraphRAG: l’evoluzione del RAG con i knowledge graph
La maggior parte dei progetti di Retrieval-Augmented Generation (RAG) avviati dalle aziende negli ultimi due anni si scontra oggi con un limite invisibile ma…
5 min di lettura
Prompt injection: la vulnerabilità che minaccia i LLM aziendali
Il prompt injection non è un semplice bug software risolvibile con una patch temporanea, ma una vulnerabilità strutturale insita nell’architettura stessa dei Large Language…
6 min di lettura
MLOps: la transizione necessaria per l’IA aziendale
L’entusiasmo iniziale per l’intelligenza artificiale generativa sta lasciando il posto a una dura realtà ingegneristica: la stragrande maggioranza dei prototipi non supera mai la…
6 min di lettura